На этой неделе авторы Хабра окончательно перешли от восхищения демо-роликами к суровой оптимизации агентного рантайма и контекста. Инженеры переписывают статические графы LangGraph на динамические библиотеки ради экономии половины токенов, подключают AST-анализаторы монорепозиториев по MCP и выявляют ловушки наивного ReAct-вызова локальных моделей. Главный практический сдвиг — отказ от общих запретов в системных инструкциях в пользу алгоритмических чек-листов и жестких ratchet-гейтов в CI, предотвращающих регрессии автокодинга.
⚡
Главные статьи недели
01
gMAS: как мы переписали рантайм LangGraph на rustworkx для динамических графов агентов
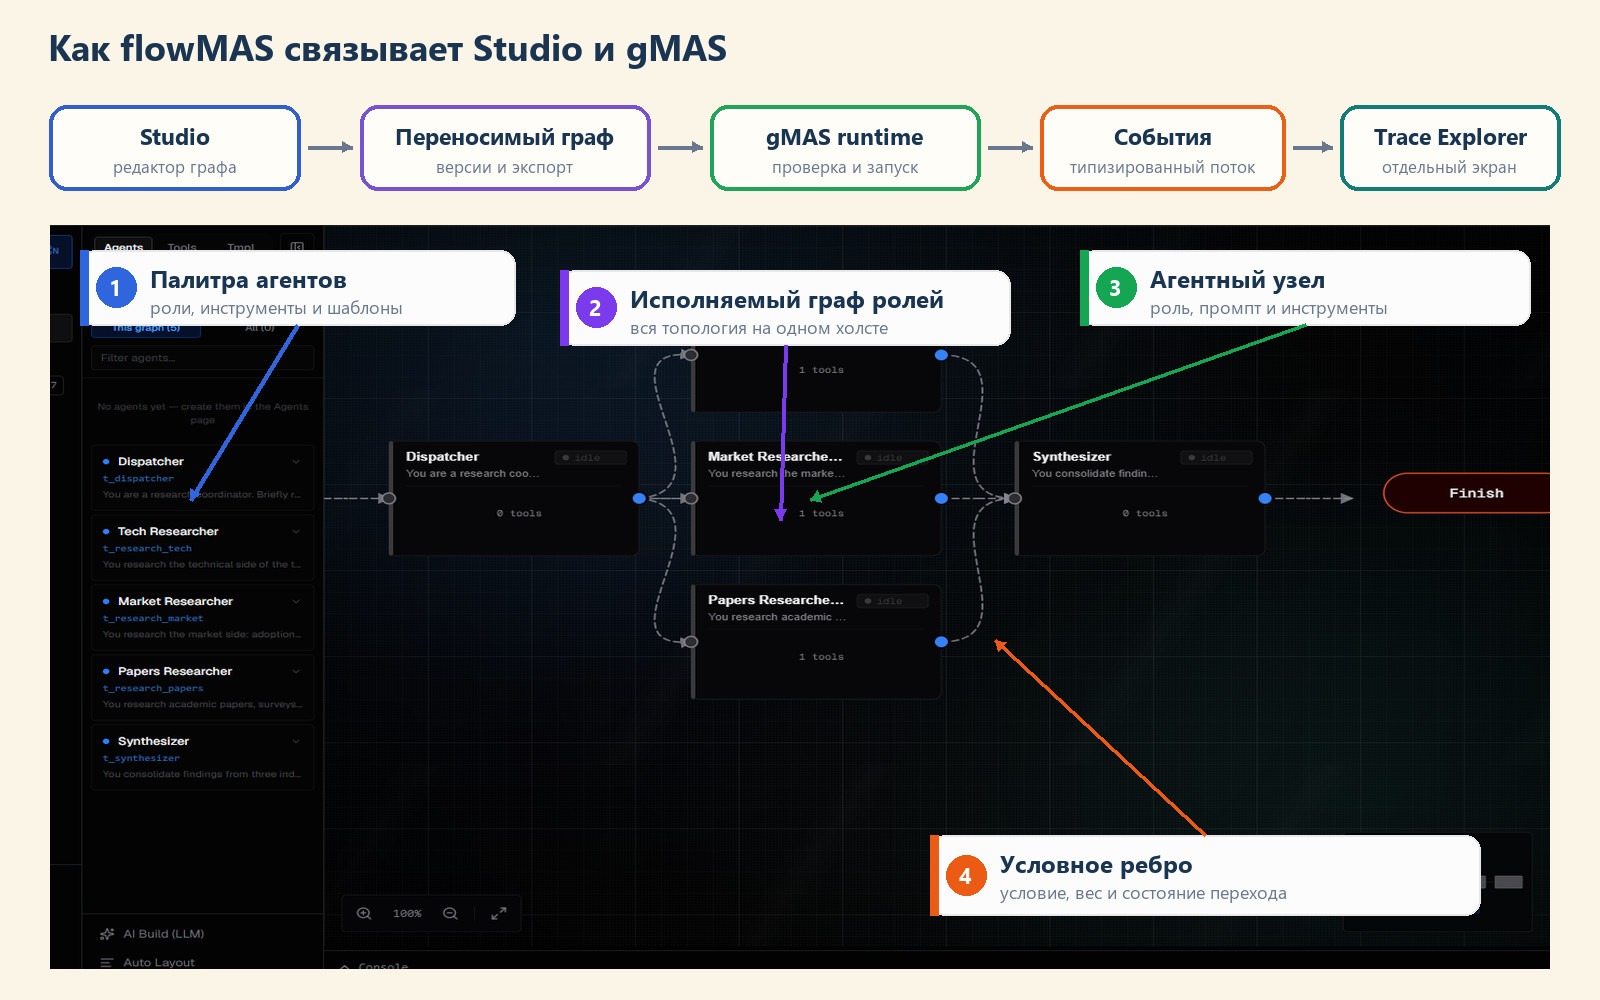
Разработчики Sber AI Lab столкнулись с ограничением LangGraph: его граф компилируется статически и не позволяет перестраивать связи агентов во время выполнения. В ответ они создали открытый фреймворк gMAS на базе графовой библиотеки rustworkx, где топология адаптируется на лету без перезапуска сессии.
🔑 Главное
Поддерживаются три уровня динамики: маршрутизация, переключение связей между агентами и создание новых узлов прямо в рантайме.
Механизм досрочной остановки тупиковых веток снизил расход токенов на 52,6%, а обучаемое прореживание графа — на 27% (исследование на бенчмарках Big-Bench Hard, GSM8k и MMLU-Pro).
Вычисления отделены от структуры: граф компилируется в плоские структуры rustworkx, обеспечивая накладные расходы планировщика менее 1 мс на шаг.
Библиотека опубликована на PyPI под именем frontier-ai-gmas и включает веб-интерфейс flowMAS для визуальной трассировки агентов.
⚡ Попробовать за вечер
Установить пакет через pip install frontier-ai-gmas и собрать динамический граф через класс gmas.GraphBuilder.
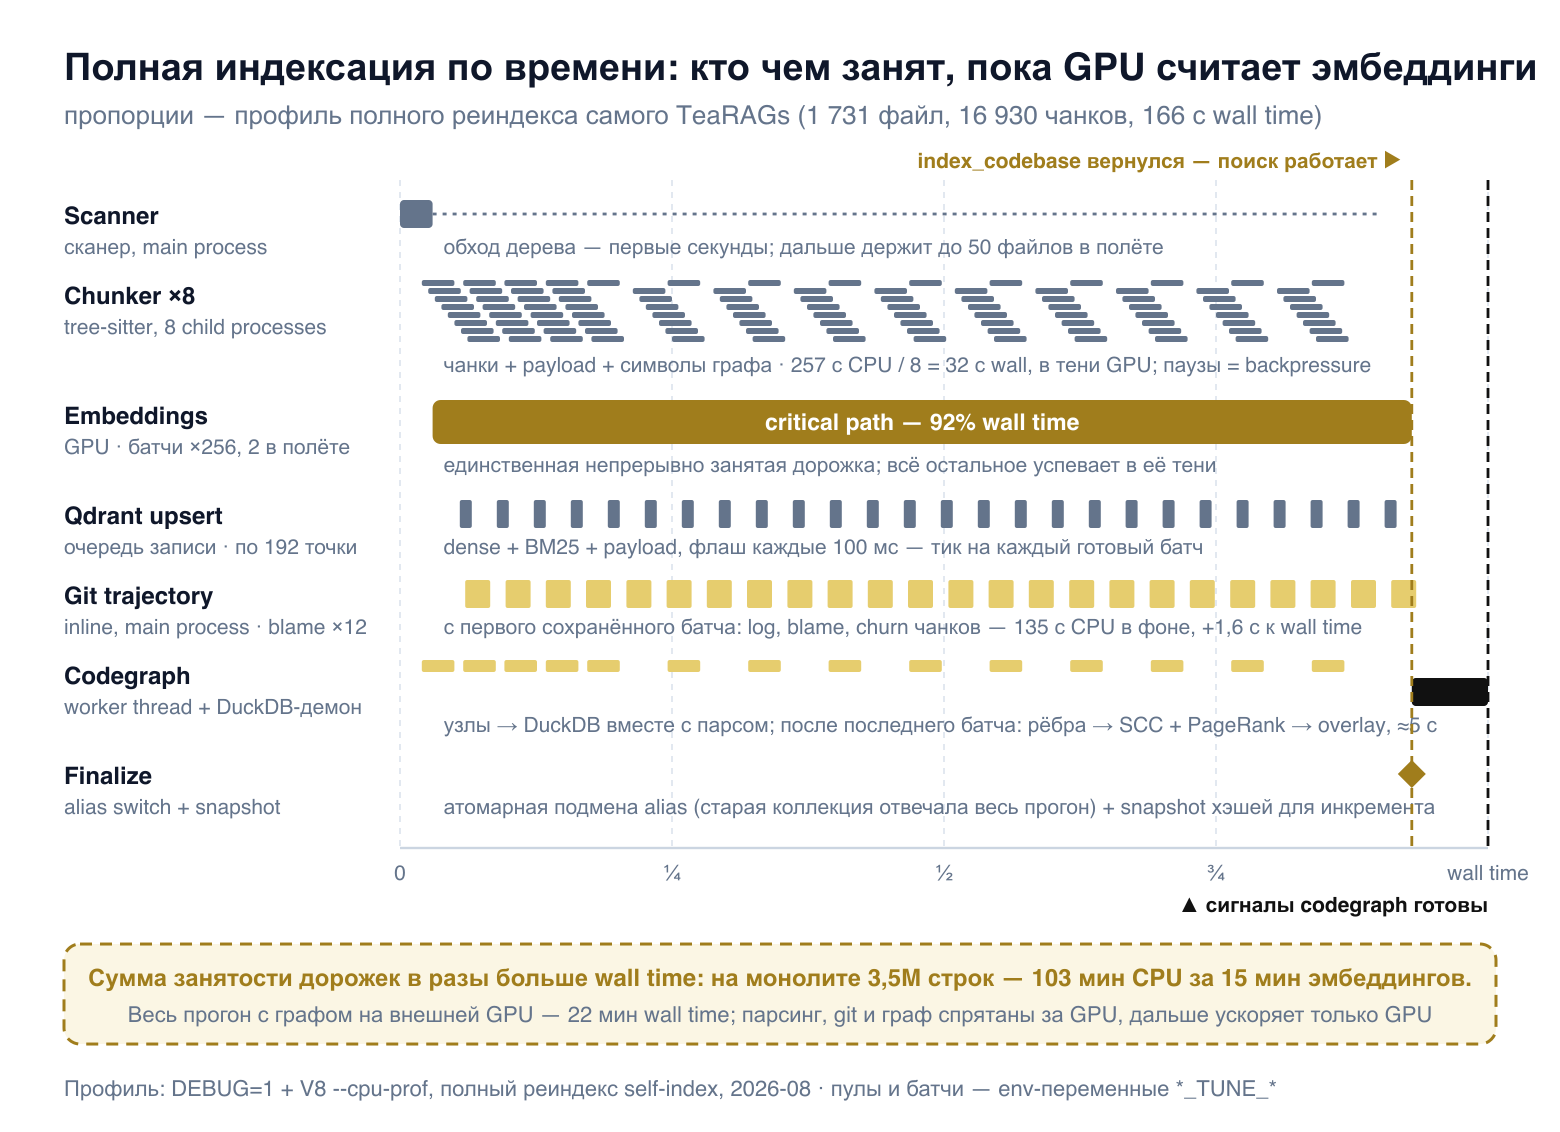
Кодинг-агенты забивают контекст слепым чтением файлов через grep и теряют связь в проектах крупнее 100 тысяч строк. Автор построил TeaRAGs — локальный сервер по протоколу MCP, объединяющий AST-граф вызовов, Git-топологию хотспотов и семантический поиск для локализации багов за 40 секунд.
🔑 Главное
Индексация монолита на 3,5 млн строк занимает менее 3 минут благодаря стриминговому алгоритму Тарьяна и PageRank с лимитом памяти 2 ГБ.
Процессные метрики Git (частота правок, churn, число контрибьюторов) предсказывают дефекты с точностью 95%, тогда как метрики стиля кода — лишь на 54%.
Инструмент передаёт агенту только 10–15 точечных сигналов вместо тысяч строк сырого кода, снижая расход входных токенов на 85%.
Полностью локальный стек: AST-парсеры tree-sitter, база DuckDB и векторное хранилище Qdrant без передачи кода во внешние облака.
⚡ Попробовать за вечер
Склонировать проект github.com/artk0de/TeaRAGs-MCP и подключить сервер к Claude Code или Cursor через MCP-манифест.
Запустить индексацию своей кодовой базы командой tearags index --path . --workers 8.
Протестировать локализацию бага через вызов инструмента mcp__tea-rags__hybrid_search с параметром rerank: "bugHunt".
Метрика: сокращение времени поиска корня ошибки агентом с 10 минут слепого перебора до менее 1 минуты.
из статьи
На диаграмме: конвейер индексации TeaRAGs — CPU-задачи (парсеры, Git-история и граф) выполняются параллельно в тени непрерывного расчета эмбеддингов на GPU.
Стандартный векторный RAG на договорах фатально ошибается: теряет номера пунктов, даты и галлюцинирует ставками неустойки. Автор подробно разбирает архитектуру промышленного пайплайна для проверки соглашений аренды, объединившего гибридный поиск со строгим вычислением на Python.
🔑 Главное
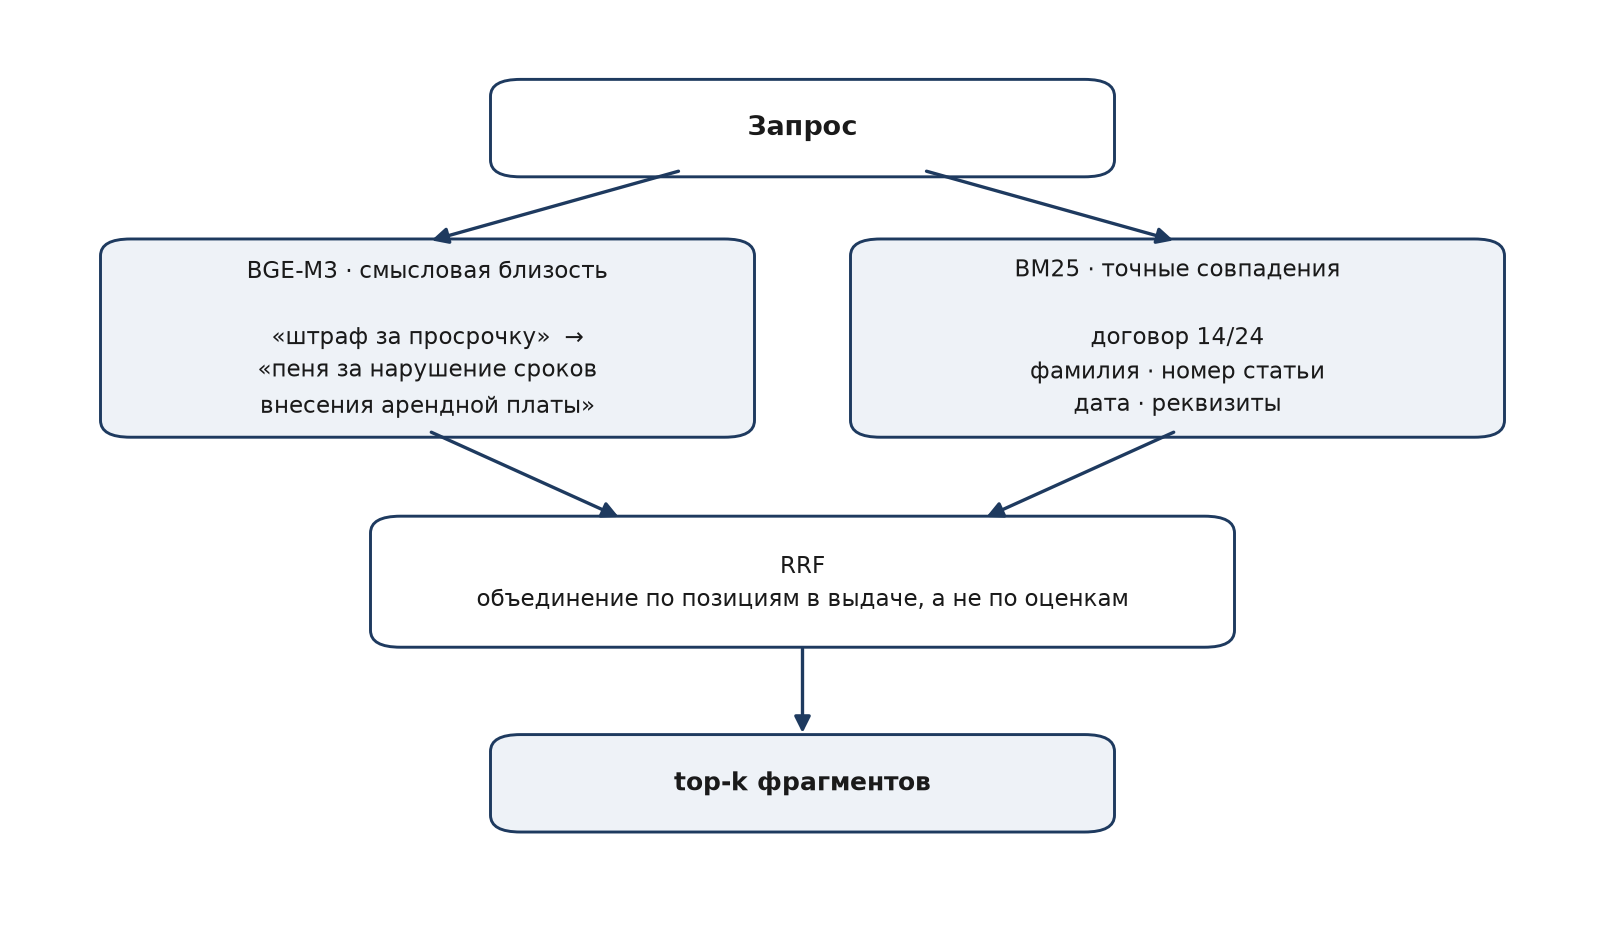
Гибридный поиск: BM25 находит точные номера статей и реквизиты, а модель BGE-M3 — контекстный смысл; слияние через Reciprocal Rank Fusion (RRF) обеспечило Recall@10 = 0,935 на 401 документе.
Cross-encoder реранкер провалился: он снизил Recall@10 до 0,806 и добавил 2,45 с задержки, поэтому от него полностью отказались.
Детерминированная маршрутизация: фактографические запросы идут в SQL, смысловые — в RAG; классификатор показал 21 из 21 попадания на регрессионном тесте.
LLM извлекает только сырые сущности в валидируемый JSON, а расчет неустоек выполняет верифицированный код без риска галлюцинаций.
⚡ Попробовать за вечер
Реализовать слияние выдачи rank_bm25 и dense-векторов BAAI/bge-m3 по формуле Reciprocal Rank Fusion.
Вынести логические и числовые расчёты из системного промпта модели в Pydantic-схему с валидатором значений.
Метрика: стопроцентная точность числовых расчётов и Recall@10 не ниже 0,90 на выборке сложных договоров.
из статьи
На схеме: архитектура гибридного RAG — разделение запроса на лексическую и семантическую ветки со слиянием по позициям в выдаче (RRF).
Автор провёл строгое тестирование локальных моделей для программирования под 16 ГБ видеопамяти (RTX 5060 Ti) в связке с кодинг-агентом OpenCode. В статье раскрыта ловушка стандартных квантов и найден точный рецепт запуска 30B-модели без вылета в своп.
🔑 Главное
Ловушка длины контекста: на 16K токенов модель выдаёт 63,8 т/с, но при росте окна до 32K скорость стандартного кванта Q3_K_M падает в 40 раз (до 1,57 т/с) из-за нехватки VRAM под KV-кэш.
Победа квантования Unsloth: файл UD-IQ3_XXS для Qwen3-Coder-30B показал скорость 42,3 т/с и освободил на 872 МБ больше памяти (1517 МБ против 645 МБ), сохранив стабильный отклик.
Проверка тулинга: модели Qwen2.5-14B и REAP-25B засыпались на вызове инструментов и создании файлов, тогда как 30B корректно управляла структурой проекта.
⚡ Попробовать за вечер
Скачать квантованный вес Qwen3-Coder-30B-A3B-Instruct-UD-IQ3_XXS.gguf.
Поучительный разбор архитектурного антипаттерна: автор попытался снизить затраты на облачный Codex, подключив через MCP локальную модель Gemma 3 в Ollama для рутинных ответов. Эксперимент показал, что расход входных токенов при этом вырос более чем в два раза.
🔑 Главное
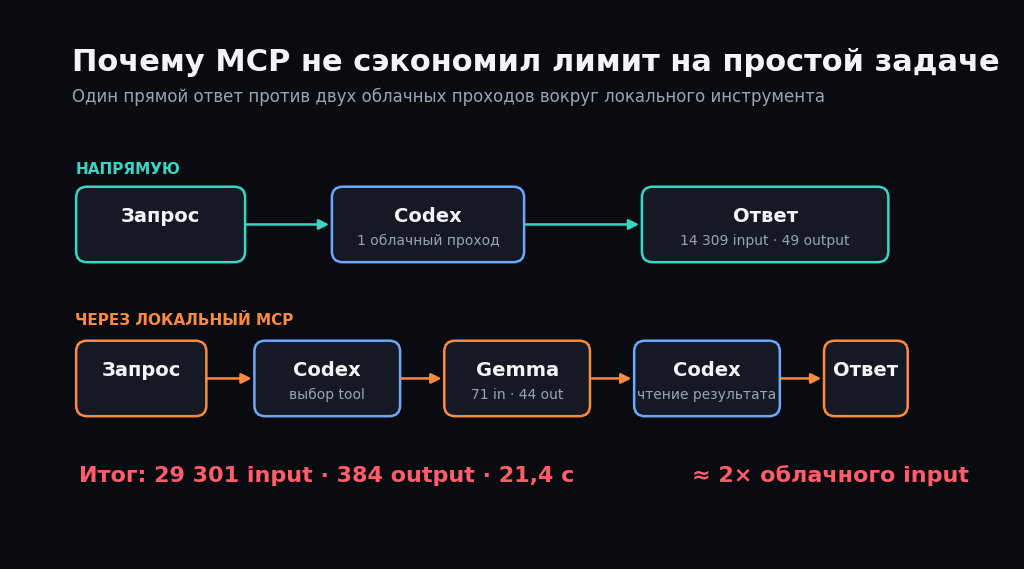
Специфика ReAct-цикла: облачный Codex тратит токены на анализ промпта и вызов тула (14 309 токенов), затем передаёт задачу в MCP, а после ответа Gemma получает весь контекст обратно (ещё 15 000 токенов) для финального ответа.
Итоги замера: прямой запрос к Codex отработал за 8,8 с и 14 309 токенов; через MCP цепочка потребовала 21,4 с и 29 301 токен (+105% к расходу).
Архитектурный вывод: подключать локальные LLM «снизу» (как инструмент агента) невыгодно. Локальная модель должна стоять «сверху» как внешний роутер, отсекая простые запросы до запуска агента.
⚡ Попробовать за вечер
Проверить лог вызовов своего агента на наличие паразитных тулов, возвращающих неизменный контекст.
Исключить вторичные генеративные модели из списка инструментов агента.
Настроить прокси-роутер перед агентом, отсекающий тривиальные запросы до формирования тяжелого промпта.
Метрика: отсутствие повторной пересылки системного контекста при выполнении простых служебных команд.
из статьи
На схеме: почему MCP не сэкономил лимит — один прямой облачный проход против двух последовательных облачных проходов вокруг локального инструмента.
Команда low-code платформы Интеграм за год работы доверила ИИ-агенту написание почти всего кода в монорепозитории (2583 смерженных PR). Автор раскладывает типичные сбои агентов на конкретные дефекты инструкций и формулирует правила их оформления в CLAUDE.md.
🔑 Главное
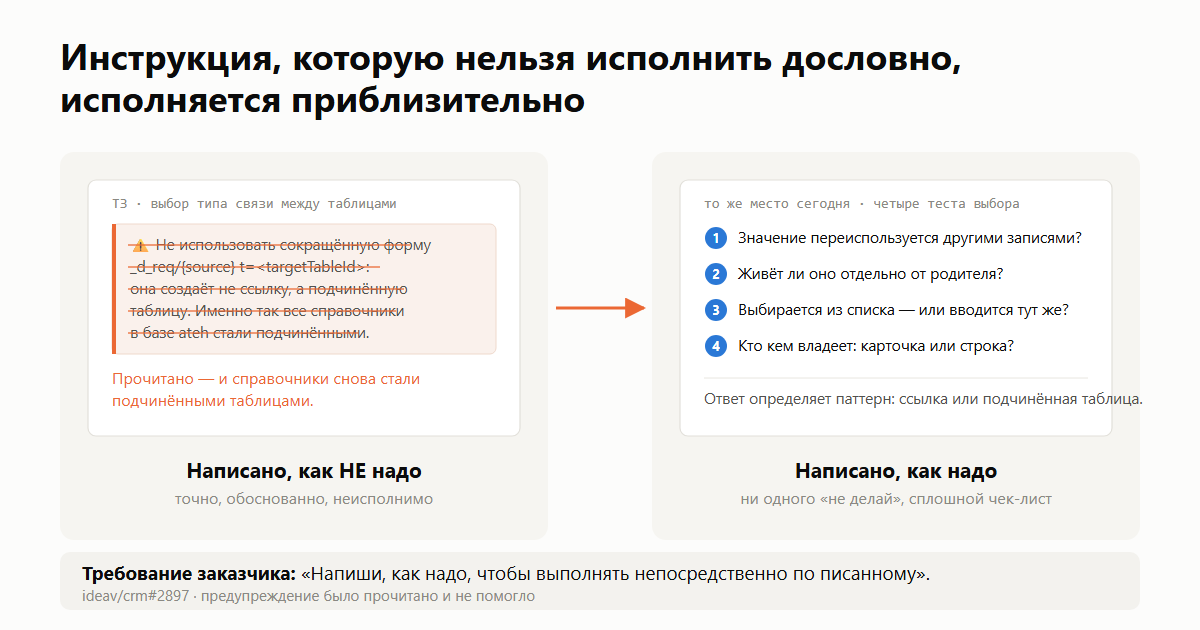
Отказ от запретов: фразы «не делай X» не работают, так как не дают альтернативы; вместо этого прописывается прямой чек-лист из 4 вопросов выбора нужного паттерна.
Иерархия источников правды: ТЗ и тикет нормативны, существующий код — описателен; ориентация на старый код заставляет агента тиражировать костыли.
Ratchet-гейты в CI: агенты склонны молча подгонять упавшие тесты под фикс; CI обязан требовать отчет «гейт: N файлов, 0 падений» и жестко блокировать правку эталонных тестов.
Сетевая изоляция: в инструкцию вшит запрет обращений к локальным подсетям (127.0.0.1, 192.168.*) и метаданным облака (169.254.169.254).
⚡ Попробовать за вечер
Переписать CLAUDE.md или .cursorrules: убрать частицы «не» и заменить их пошаговыми алгоритмами выбора.
Добавить в pre-commit хук проверку контрольной суммы файлов с эталонными тестами.
Внести список запрещенных IP-диапазонов в системный промпт проекта.
Метрика: полное отсутствие рецидивов по уже исправленным архитектурным ошибкам.
из статьи
На схеме: наглядная разница между запретом «как НЕ надо» и прямым пошаговым чек-листом «как надо», исполняемым агентом без двусмысленности.
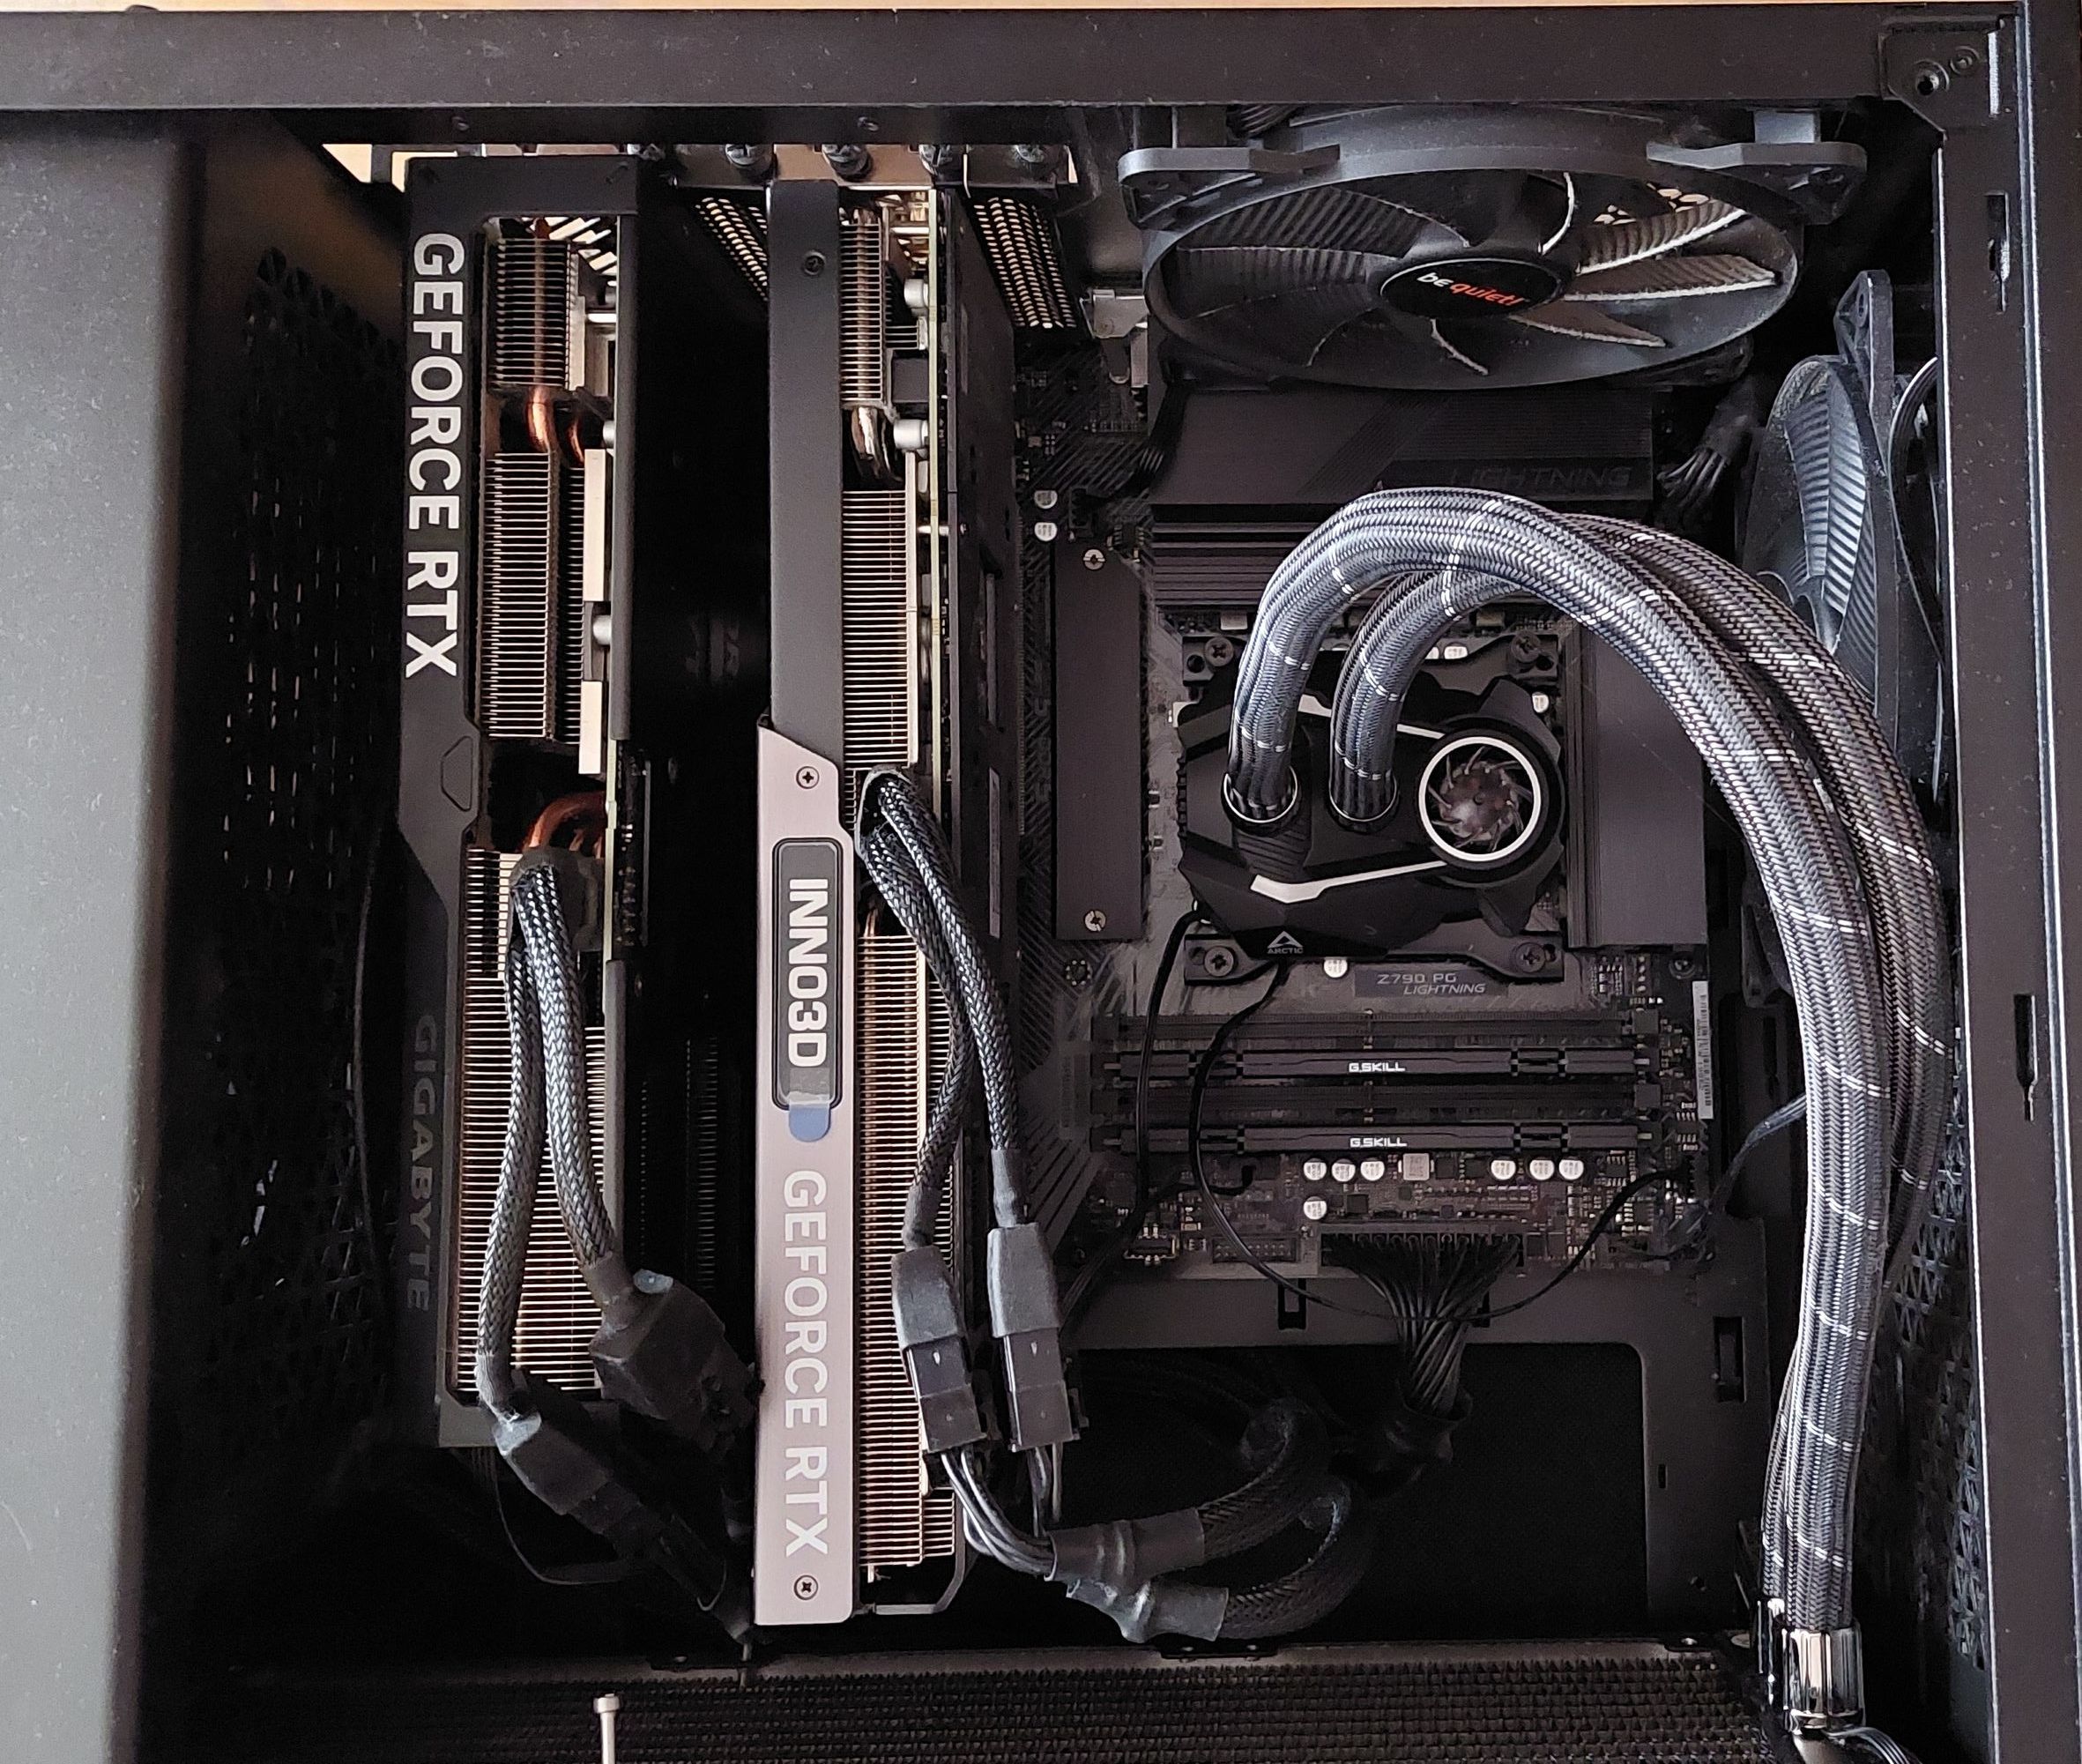
Практический отчет о сборке домашней рабочей станции для автономного ассистента на двух видеокартах по 12 ГБ (суммарно 24 ГБ VRAM, PCIe 4.0 x8/x8). Система объединяет языковую модель с векторным поиском LanceDB, графовой памятью Neo4j и голосовым интерфейсом.
🔑 Главное
Сравнение рантаймов: LM Studio показала двукратное превосходство над Ollama на модели Qwen3.8-27B-Q4_0 — 58,4 т/с против 27,3 т/с благодаря более быстрому распределению слоёв.
Реальный лимит VRAM: при 22 ГБ свободной памяти порог загрузки без вылета в системную RAM проходит на уровне 19,5 ГБ (остаток уходит под KV-кэш и буферы).
Графовая память: комбинация LanceDB для поиска фрагментов и Neo4j через MCP-сервер позволяет связывать факты о проектах в структурированный граф.
⚡ Попробовать за вечер
Настроить параллельный запуск модели на двух GPU через мульти-GPU профиль в LM Studio или флаги тензорного параллелизма в llama.cpp.
Поднять локальный контейнер Neo4j и подключить MCP-сервер графовой памяти к своему ассистенту.
Метрика: скорость инференса 27B-моделей не ниже 50 токенов/с при полном отсутствии свопа в системную память.
из статьи
На фотографии: рабочая станция с двумя видеокартами RTX 4070 Ti/Super, обеспечивающими 24 ГБ VRAM для запуска 27B–32B моделей.
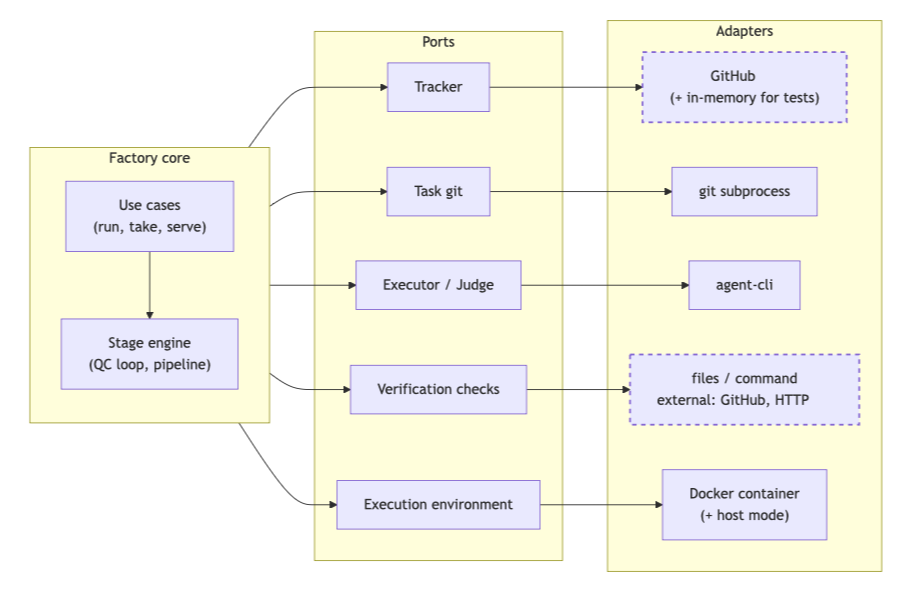
Когда базовая работа с кодинг-агентами отлажена, узким местом становится дежурство разработчика у терминала. Автор представил открытую фабрику Gnomish Factory, где агенты автономно берут тикеты, проектируют изменения по спецификациям OpenSpec и зовут человека только при возникновении блокеров.
🔑 Главное
Процессная модель IDEF0/ICOM: стадии разработки описаны в stage.yaml и pipeline.yaml с жестко заданными входами, выходами и валидаторами.
Фазовый цикл OpenSpec: агент проходит этапы исследования кодовой базы (/opsx:explore), подготовки предложений (/opsx:propose) и пошагового применения (/opsx:apply-sequential).
Парковка задач: при неоднозначности в требованиях агент переводит тикет в статус gnomish:needs-human, прикладывает лог и сразу берёт следующую задачу, не простаивая.
⚡ Попробовать за вечер
Склонировать репозитории github.com/oinsio/gnomish-factory и тестовый стенд github.com/oinsio/gf-tests.
Настроить запуск агента Claude Code в пакетном режиме над репозиторием.
Метрика: автономное создание pull request по тикету без ручного вмешательства на промежуточных фазах.
из статьи
На схеме: архитектура Gnomish Factory — порты и адаптеры для интеграции с трекерами задач, Git-подпроцессами и песочницами Docker.
Опыт сборки компактной мультимодальной модели на базе InternViT-300M и Baguettotron: эффективный трюк pixel unshuffle и анализ деградации этапа рассуждений.
Экономический расчёт домашней сборки с 32 ГБ быстрой памяти HBM2 по цене $150 за модуль, сложности с охлаждением и тонкости сборки PyTorch под архитектуру Volta.
Критический разбор концепции LLM-wiki Андрея Карпатого на базе 6000 заметок в Obsidian: типизированный frontmatter и ритуалы сохранения человеческой памяти.
 из статьи